
Monitoring در SMS Gateway؛ چه شاخصهایی را باید پایش کنیم؟
Monitoring در SMS Gateway یعنی مشاهدهٔ پیوستهٔ سلامت مسیر پیام از API تا صف، مسیریابی، اتصال اپراتور و گزارش تحویل. داشبوردی که فقط «تعداد پیام ارسالشده» را نشان دهد، برای تشخیص کندی یا اختلال کافی نیست. باید نرخ ورود و خروج، سن صف، تأخیر هر مرحله، خطاها و وضعیت مسیرها را با شناسه و زمان یکسان کنار هم دید.
در یک سرویس سازمانی، کاربر معمولاً نتیجه را با این پرسش میسنجد: «پیام بهموقع رسید یا نه؟» تیم عملیات برای پاسخ باید بداند درخواست چه زمانی پذیرفته شد، چه مدت در صف ماند، از کدام مسیر رفت و چه وضعیتی برگشت. بدون این زنجیره، افزایش سرور یا تغییر مسیر میتواند فقط علامت را جابهجا کند. این راهنما شاخصهای ضروری، طراحی داشبورد، اولویتبندی هشدار و چکلیست نخستین بررسی رخداد را پوشش میدهد. برای شناخت اجزای مسیر، معماری SMS Gateway سازمانی را ببینید.
چرا Monitoring SMS Gateway باید کل مسیر را ببیند؟
مسیر یک پیام میتواند از برنامهٔ سازمان به API، Backend، Queue، موتور Routing، اتصال بالادستی و شبکهٔ مقصد برسد. هر مرحله ممکن است درخواست را بپذیرد، منتظر نگه دارد، رد کند یا نتیجهای با تأخیر برگرداند. سالم بودن API بهتنهایی به معنی خروج پیام از صف نیست؛ پذیرش اپراتور نیز تحویل به گوشی را ثابت نمیکند. بنابراین وضعیت کسبوکار باید با وضعیت فنی چند مرحله سنجیده شود.
پاسخ کوتاه: برای پایش عملی، دستکم نرخ درخواست، نرخ خروج پیام، عمق و سن صف، تأخیر API و مسیر، خطا به تفکیک علت، سلامت اتصال اپراتوری و وضعیت گزارش تحویل را کنار هم بگذارید. تعریف هر شاخص، واحد و بازهٔ زمانی آن باید در داشبورد روشن باشد.
هدف، ساختن صفحهای پر از نمودار نیست؛ هدف این است که تیم عملیات بتواند در چند دقیقه تشخیص دهد کدام مرحله از مسیر رفتار غیرعادی دارد و آیا کاربر واقعاً متأثر شده است. تفکیک شاخصها بهازای سرویس، نوع پیام، مسیر، اپراتور و زمان، برای یافتن علت مفید است؛ اما برچسبهای بیش از حد جزئی میتوانند داده را شلوغ و پرهزینه کنند. شناسهٔ مشترک پیام، کلید اتصال رویدادهاست.
کدام شاخصهای SMS Gateway را پایش کنیم؟
۱. دسترسپذیری API و سرویسهای اصلی
نخست ببینید نقطهٔ ورود قابل دسترس است و درخواست معتبر را میپذیرد یا نه. نرخ پاسخ موفق، خطاهای سمت سرور، زمان پاسخ و وضعیت سرویسهای وابسته را جدا ثبت کنید. یک آزمون سلامت ساده ممکن است پاسخ دهد، در حالی که ثبت واقعی پیام به علت خطای پایگاه داده یا صف شکست بخورد. برای همین، بررسی مصنوعی یک مسیر کمخطر و مشاهدهٔ نتیجهٔ آن، مکمل وضعیت فرایندهاست؛ اجرای چنین آزمونی باید با دادهٔ مجاز و سیاست عملیاتی سازمان هماهنگ باشد.
۲. نرخ ورود، نرخ خروج و توان عملیاتی
تعداد درخواستهای پذیرفتهشده در API را با تعداد پیامهای خروجی از صف و پیامهای پذیرفتهشده در مسیر بالادستی مقایسه کنید. اگر ورودی برای مدتی از خروج بیشتر شود، backlog شکل میگیرد. عدد TPS فقط زمانی معنیدار است که مرز سنجش، واحد «درخواست/پیام/بخش» و پنجرهٔ زمانی مشخص باشد. نرخ لحظهای را در کنار نرخ پایدار و زمان انتظار پیامها بخوانید؛ عدد بالای پذیرش API بدون خروج متناسب، نشانهٔ ظرفیت کافی نیست.
۳. عمق صف و سن قدیمیترین پیام
Queue Depth تعداد پیامهای منتظر است، اما بهتنهایی شدت مشکل را نشان نمیدهد. صفی با تعداد زیاد و خروجی سریع ممکن است زود تخلیه شود؛ صفی کوچک با پیامهای بسیار قدیمی برای OTP یا اعلان زمانحساس خطرناکتر است. سن قدیمیترین پیام، زمان انتظار در صدکهای بالا و نرخ تخلیه را همراه عمق صف ببینید. صفهای دارای اولویت یا مقصد متفاوت را جدا پایش کنید تا تراکم یک مسیر در میانگین کل پنهان نشود. راهنمای Queue پیامک نشانههای گلوگاه را توضیح میدهد.
۴. تأخیر هر مرحله و زمان انتها به انتها
زمان پاسخ API، زمان انتظار صف، زمان واگذاری به مسیر و زمان دریافت گزارش تحویل، چهار تأخیر متفاوتاند. برای هر کدام زمان شروع و پایان روشن تعریف کنید. میانگین ممکن است چند پیام بسیار دیررس را پنهان کند؛ صدکهای تأخیر برای سناریوهای حساس به زمان مفیدترند. با این حال، «زمان رسیدن به گوشی» را از زمان دریافت DLR با قطعیت یکسان فرض نکنید، زیرا معنای وضعیت و زمان گزارش به مسیر وابسته است.
۵. نرخ خطا و علت شکست
خطا را فقط بهصورت یک درصد کلی نشان ندهید. رد اعتبارسنجی، خطای دسترسی، محدودیت نرخ، مشکل اتصال، پاسخ نامعتبر اپراتور و وضعیت نامعلوم هر کدام اقدام متفاوتی دارند. خطاهای گذرا را از خطاهای قطعی جدا کنید و ببینید آیا سیاست Retry در زمان اختلال بار اضافی میسازد. نرخ خطا را هم بر اساس تعداد درخواست و هم بر اساس پیامهای نهایی گزارش کنید تا تکرار تلاشها تصویر را مخدوش نکند.
۶. سلامت مسیر اپراتوری و Routing
برای هر اتصال، وضعیت نشست، زمان پاسخ، پذیرش یا رد پیام، timeout و تغییر ناگهانی نرخ را ببینید. اگر یک مسیر کند شود اما مسیر دیگر سالم بماند، نمودار تجمیعی ممکن است مسئله را پنهان کند. مانیتورینگ مسیر باید به تصمیم Routing پیامک وصل باشد: چه مقدار ترافیک به هر مسیر رفته، چرا مسیر انتخاب شده و پس از خطا چه اتفاقی افتاده است؟ وجود مسیر جایگزین بدون مشاهدهٔ نتیجهٔ سوییچ کافی نیست.
۷. وضعیت تحویل و کیفیت دادهٔ DLR
نرخ تحویل گزارششده، نرخ شکست و سهم وضعیت نامعلوم را بر اساس پنجرهٔ ارسال و گروه پیام بررسی کنید. DLR ممکن است با تأخیر برسد؛ بنابراین مقایسهٔ «ارسالهای همین دقیقه» با «گزارشهای همین دقیقه» میتواند گمراهکننده باشد. برای تحلیل همدوره، پیامها را با زمان ایجاد یا واگذاری گروهبندی و بعد نتیجهٔ نهاییشان را دنبال کنید. نبود گزارش را بهطور خودکار شکست قطعی فرض نکنید؛ زمان انتظار و سیاست تعیین وضعیت نامعلوم باید مشخص باشد.
۸. سلامت Backend و منابع زیرساخت
CPU، حافظه، فضای دیسک، اتصال پایگاه داده، زمان پرسوجو، تعداد worker و تأخیر پردازش رویدادها به یافتن علت کمک میکنند. این شاخصها برای تشخیص ریشه مهماند، اما نباید جای شاخصهای اثرگذار بر کاربر را بگیرند. برای مثال، افزایش CPU بدون افزایش خطا یا تأخیر لزوماً حادثهٔ فوری نیست؛ رشد سن صف همراه افت نرخ خروج، اثر مستقیمتری بر موعد ارسال دارد. وابستگی سرویسها را در راهنمای Failover نیز میتوان دید.
داشبورد Monitoring پیامک را چگونه طراحی کنیم؟
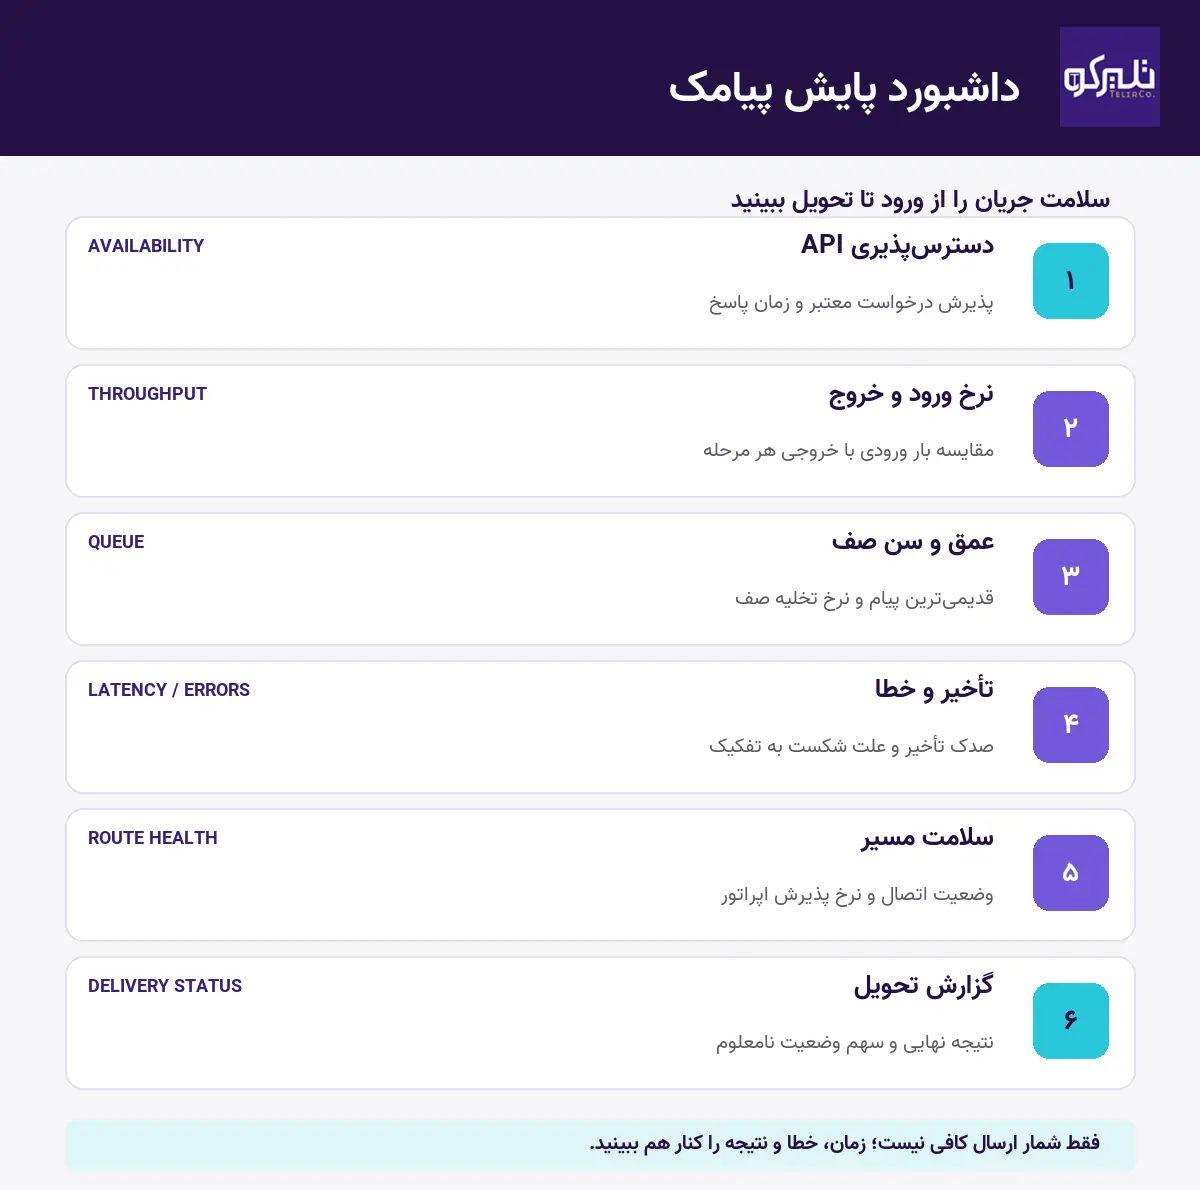
داشبورد اصلی باید از بالا به پایین پاسخ دهد: آیا ارسال برای کاربران سالم است؟ اگر نه، مشکل از چه زمانی آغاز شده و به کدام نوع پیام یا مسیر محدود است؟ سپس صفحهٔ جزئیات هر لایه به تیم اجازه دهد علت را دنبال کند. یک نمای واحد برای NOC، پشتیبانی و مدیر فنی همیشه کافی نیست؛ اما تعریف شاخصها باید در همهٔ نماها یکسان بماند.
| لایهٔ داشبورد | نمای ضروری | پرسش تصمیمگیری |
|---|---|---|
| اثر بر کاربر | موعد پیامهای زمانحساس، خطا و وضعیت نهایی | چه گروهی از مخاطبان متأثر شدهاند؟ |
| جریان پیام | نرخ ورود و خروج، عمق و سن صف | کار در کدام مرحله جمع میشود؟ |
| مسیر و تحویل | پذیرش هر مسیر، خطا، DLR و وضعیت نامعلوم | اختلال سراسری است یا محدود به یک مسیر؟ |
| زیرساخت | Backend، worker، پایگاه داده و اتصالها | کدام وابستگی علت احتمالی است؟ |
برای هر نمودار واحد، بازهٔ زمانی، منطقهٔ زمانی و منبع داده را نشان دهید. نرخ را با شمار کل اشتباه نگیرید؛ «تعداد خطا» در زمان افزایش شدید ترافیک ممکن است بالا برود، در حالی که نسبت خطا ثابت مانده است. برعکس، درصد خطا در حجم بسیار کم میتواند با یک مورد جهش کند. نمایش همزمان شمار و نسبت، تفسیر را دقیقتر میکند. در سناریوهای Peak Traffic، بازههای کوتاه و بلند را کنار هم بررسی کنید.
چه زمانی و برای چه چیزی هشدار بدهیم؟
هشدار خوب به یک اقدام مشخص منتهی میشود. اگر هر تغییر کوتاه در CPU یا صف، اعلان فوری بسازد، تیم بهمرور هشدارها را نادیده میگیرد. ابتدا نشانهٔ اثر بر کاربر را تعریف کنید: عبور تأخیر از موعد کسبوکار، افزایش خطاهای قابل مشاهده، توقف تخلیهٔ صف یا افت معنادار تحویل. سپس هشدارهای تشخیصی لایههای پایینتر را برای یافتن علت به آن متصل کنید.
آستانهها را از baseline ترافیک واقعی، ساعت روز، روز هفته و نوع پیام استخراج کنید. یک حد ثابت برای همهٔ سرویسها ممکن است یا حساسیت کاذب بسازد یا اختلال مهم را دیر نشان دهد. هشدار باید پنجرهٔ زمانی و حداقل نمونهٔ کافی داشته باشد؛ ولی آنقدر دیر صادر نشود که پیام زمانحساس بیفایده شود. این تعادل با آزمون رخدادهای واقعی و بازبینی هشدارهای قبلی به دست میآید، نه با یک عدد عمومی برای همهٔ سازمانها.
در متن هشدار، نام سرویس، مسیر یا گروه پیام، زمان آغاز، شاخص عبورکرده از حد، لینک داشبورد و اقدام اول را بیاورید. مالک هر هشدار و مسیر ارجاع نیز باید روشن باشد. اگر مسیر اصلی قطع شده، صرفاً «Failover انجام شد» کافی نیست؛ نرخ پذیرش مسیر جایگزین، رشد صف و وضعیت پیامهای در حال پردازش را هم پایش کنید.
چکلیست سریع بررسی رخداد در SMS Gateway
- اثر را مشخص کنید: چه نوع پیام، چه گروه مقصد، کدام مشتری یا سرویس و از چه زمانی متأثر شده است؟
- ورود و خروج را مقایسه کنید: آیا API درخواست میپذیرد؟ نرخ خروج از صف و پذیرش مسیر نسبت به قبل چه تغییری دارد؟
- سن صف را ببینید: آیا پیامهای قدیمی ماندهاند و آیا صف بعد از فروکش ترافیک تخلیه میشود؟
- خطاها را دستهبندی کنید: محدودیت نرخ، timeout، خطای داده، خطای اتصال و وضعیت نامعلوم را جدا کنید.
- مسیرها را تفکیک کنید: آیا اختلال فقط روی یک اتصال یا مقصد است؟ تغییر Routing یا Failover چه اثری داشته است؟
- زیرساخت را بررسی کنید: worker، پایگاه داده، منابع و سرویسهای وابسته را با زمان آغاز رخداد تطبیق دهید.
- بازیابی را تأیید کنید: فقط سالم شدن API کافی نیست؛ نرخ خروج، سن صف و نتیجهٔ پیامهای عقبمانده را تا بازگشت به رفتار عادی دنبال کنید.
پس از رخداد، زمانبندی رویدادها و تصمیمها را ثبت کنید: نخستین نشانه چه بود، هشدار چه زمانی رسید، کدام داده به تشخیص کمک کرد و کدام داده کم بود؟ نتیجه باید به اصلاح داشبورد، آستانهٔ هشدار یا مسیر ارجاع تبدیل شود. اگر مشکل در ظرفیت تکرار میشود، فقط پاک شدن صف را پایان کار ندانید؛ الگوی بار و محدودیت پایدار را دوباره بررسی کنید.
پرسشهای رایج دربارهٔ مانیتورینگ SMS Gateway
مهمترین شاخص برای شروع Monitoring پیامک چیست؟
یک شاخص کافی نیست. نرخ ورود و خروج، سن صف، تأخیر و خطاهای قابل مشاهده برای کاربر، حداقل تصویر لازم از سلامت جریان را میدهند.
آیا تعداد پیامهای ارسالشده نشاندهندهٔ سلامت سرویس است؟
خیر. ممکن است تعداد ارسال بالا باشد، ولی بخشی از پیامها در صف دیر برسند یا یک مسیر مشخص خطا بدهد. نرخ را با تأخیر، خطا و وضعیت نهایی بخوانید.
تفاوت Queue Depth و Queue Age چیست؟
Queue Depth تعداد پیامهای منتظر را نشان میدهد؛ Queue Age مدت انتظار پیامها، بهویژه قدیمیترین یا صدکهای بالا، را نشان میدهد. برای پیام زمانحساس، سن صف بسیار مهم است.
چرا نرخ تحویل با نرخ ارسال در همان دقیقه برابر نیست؟
گزارش تحویل ممکن است بعدتر برگردد و به رویدادهای ارسال قبلی مربوط باشد. برای مقایسهٔ دقیق، پیامها را بر اساس زمان ارسال گروهبندی و نتیجهشان را در پنجرهٔ مناسب دنبال کنید.
آستانهٔ هشدار را چگونه تعیین کنیم؟
با baseline واقعی، موعد کسبوکار و تحمل خطا شروع کنید؛ سپس آن را با رخدادهای واقعی تنظیم کنید. برای همهٔ سازمانها و همهٔ نوع پیام، عدد واحدی وجود ندارد.
مسیر پیام را از ابتدا تا نتیجه پایش کنید
اگر داشبورد فعلی فقط شمار پیامهای ارسالشده را نشان میدهد یا هنگام رخداد گلوگاه روشن نیست، معماری پایش را از API تا صف، Routing، مسیر اپراتور و DLR بازبینی کنید. برای بررسی فنی زیرساخت پیامکی و راهکار SMS Gateway تلیرکو، درخواست مشاوره ثبت کنید.
منابع فنی: راهنمای Messaging Insights در Twilio، داشبورد معیارهای AWS End User Messaging، پایش تحویل SMS با CloudWatch، اصول طراحی هشدار Prometheus. این منابع برای توضیح روش عمومی پایشاند و به معنی استفادهٔ تلیرکو از این ارائهدهندگان نیستند.